将 Firecrawl 接入 Open Flow
把一页资料或一个网络研究问题整理成有来源的简明答案。
每月 20,000 次免费应用调用(付费服务另计)
可以做什么
搜索网络、阅读页面、梳理网站并采集多个链接的内容;不适合使用缓存时,请说明时效要求。
搜索与提取页面
搜索网络来源、查找站点 URL,并按所选格式提取内容。
收集多个页面
提交批量抓取或站点抓取任务,查询状态并获取结果。
使用 Firecrawl 的模板
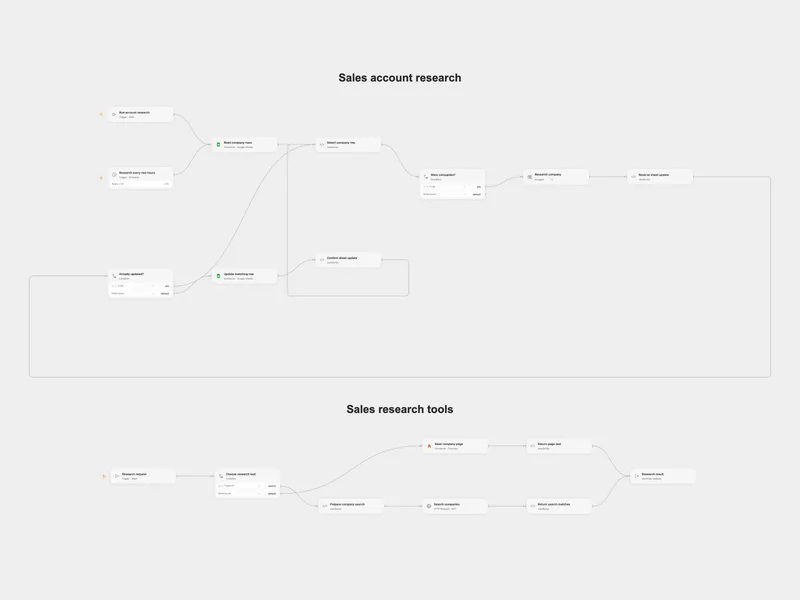
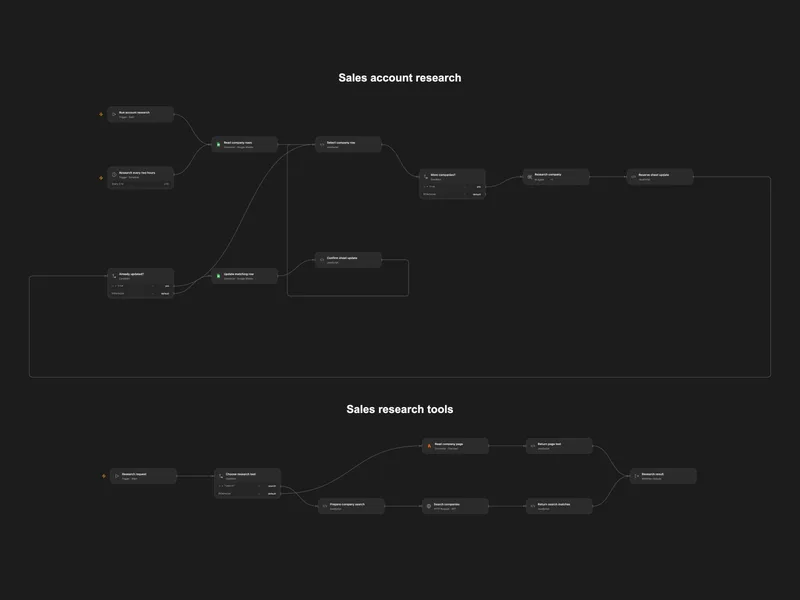
Research Sales Accounts in Google Sheets
Research companies on the web and update their matching spreadsheet rows.
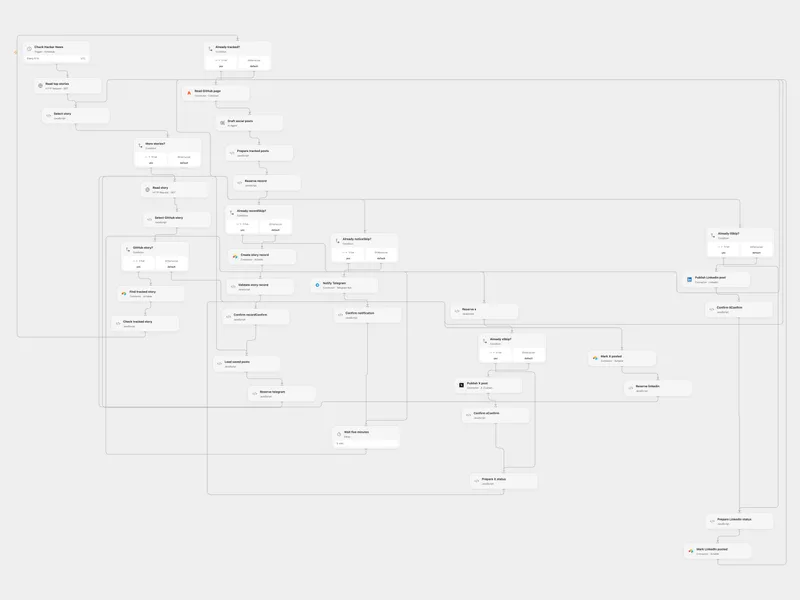
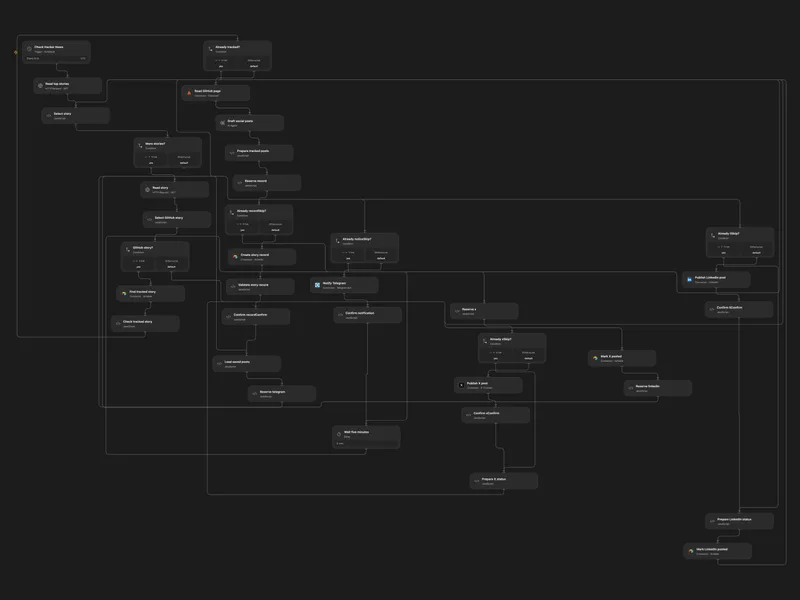
Amplify Hacker News GitHub Projects
Discover GitHub links on Hacker News, draft social posts and publish them after a short delay.
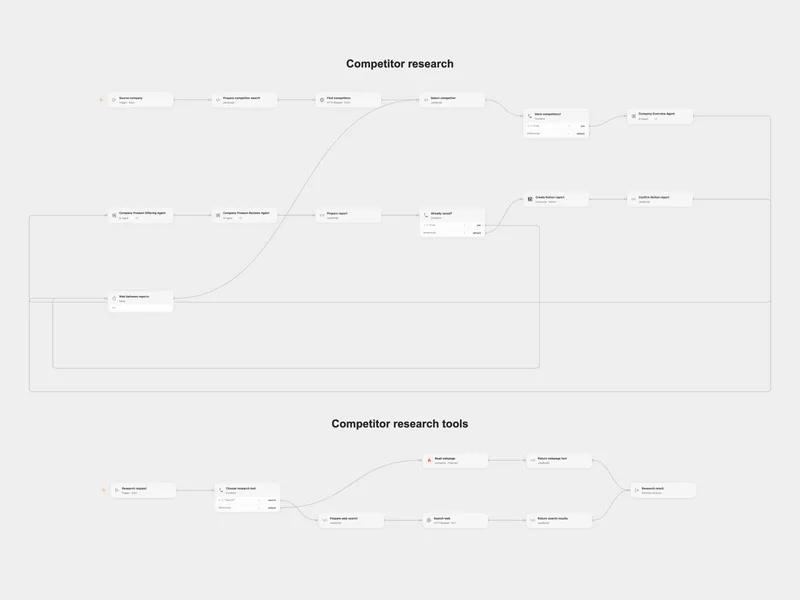
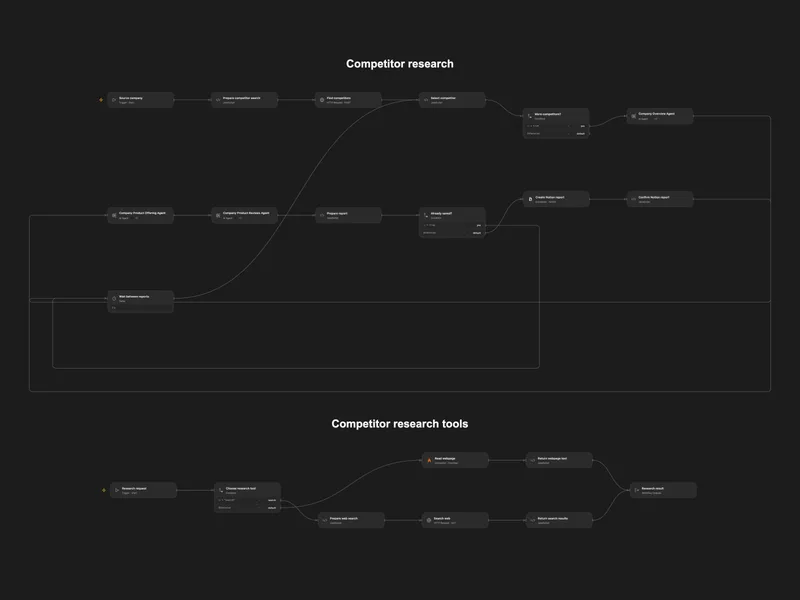
Research Competitors into Notion
Find competitors and research their company, products, and reviews in Notion.
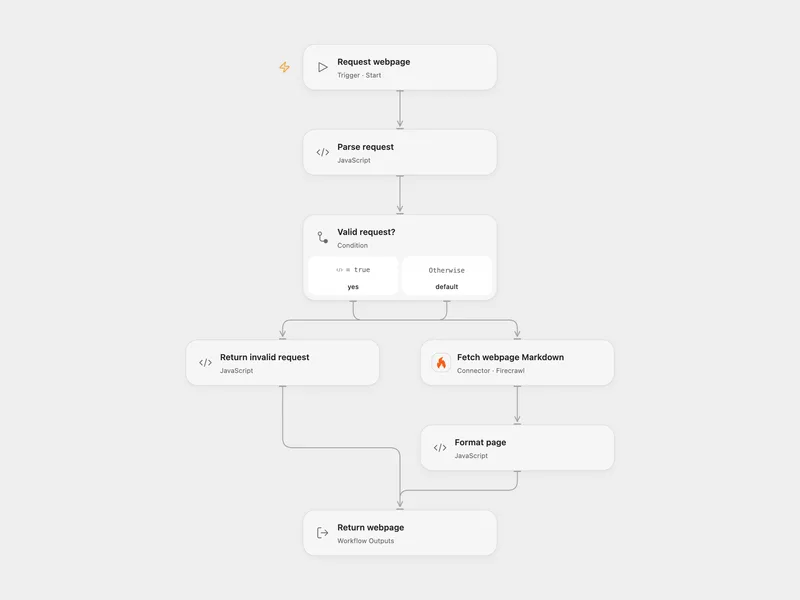
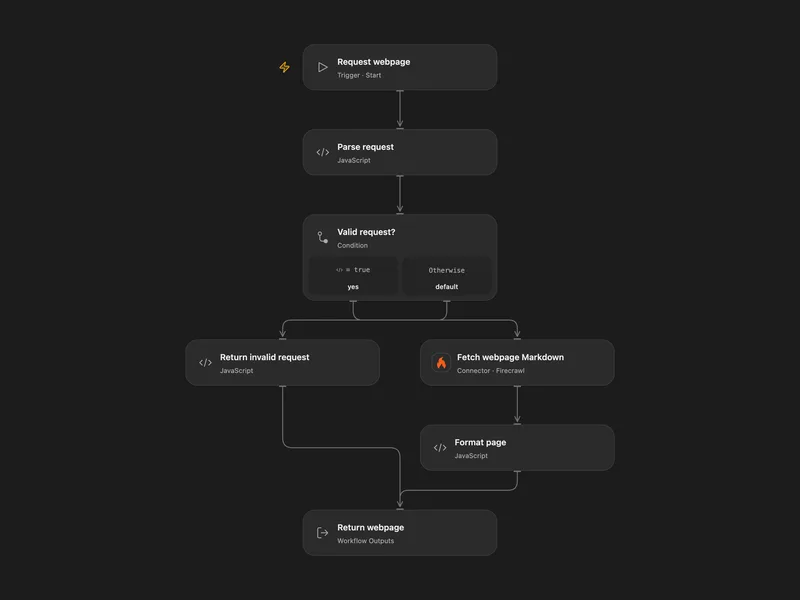
Fetch Webpage as Markdown
Fetch a webpage and return its Markdown content, optionally replacing links and image URLs.
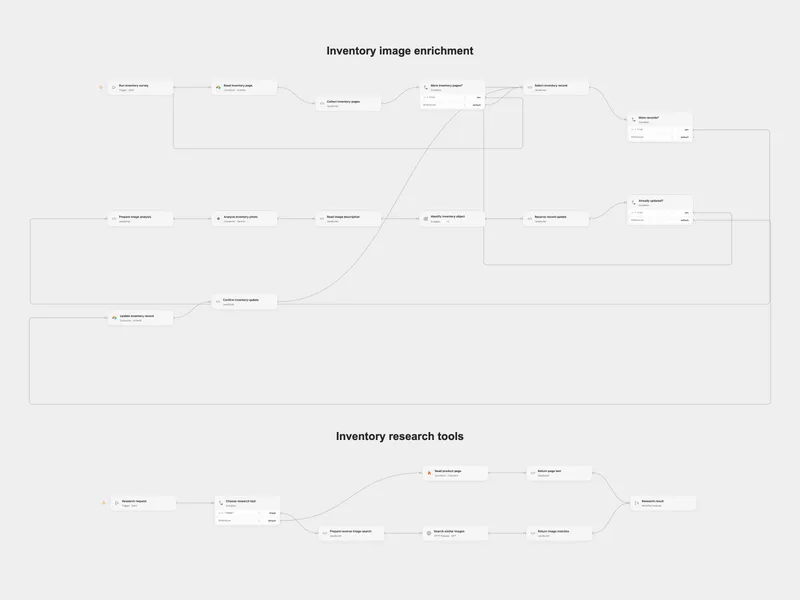
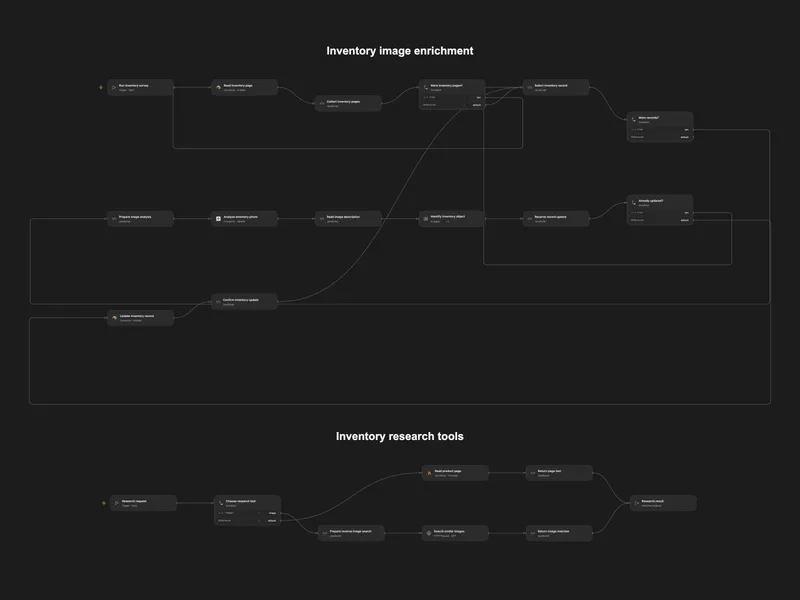
Enrich Property Inventory from Images
Analyze inventory photos and enrich Airtable records with product attributes.
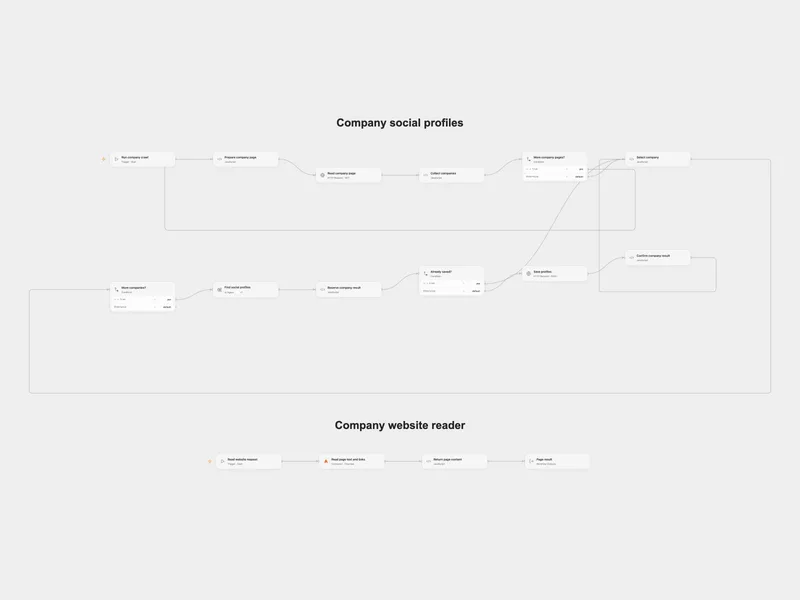
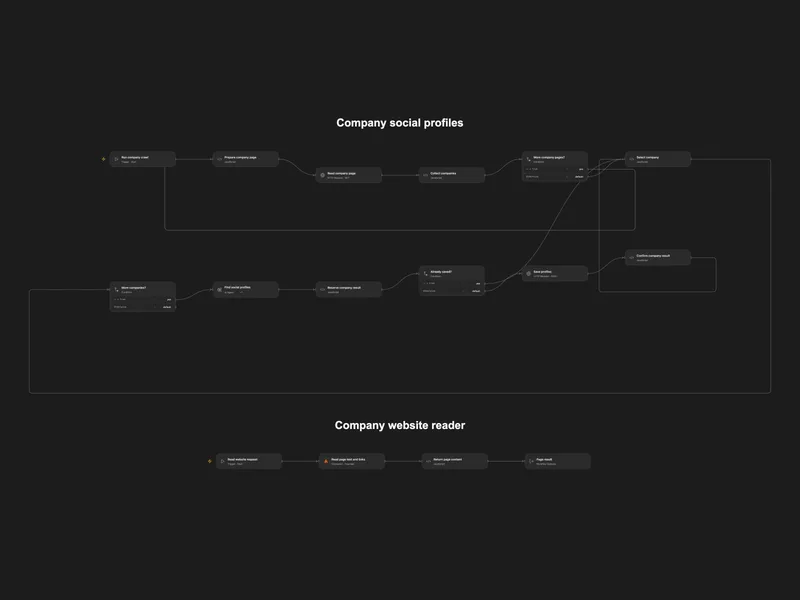
Crawl Company Social Profiles
Find company social profiles by exploring their websites and save the results to Supabase.
更多模板(5)
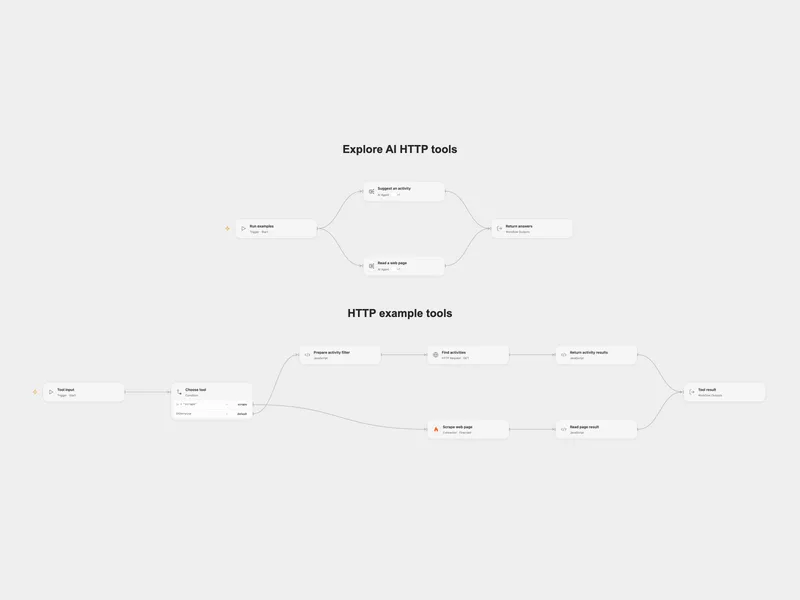
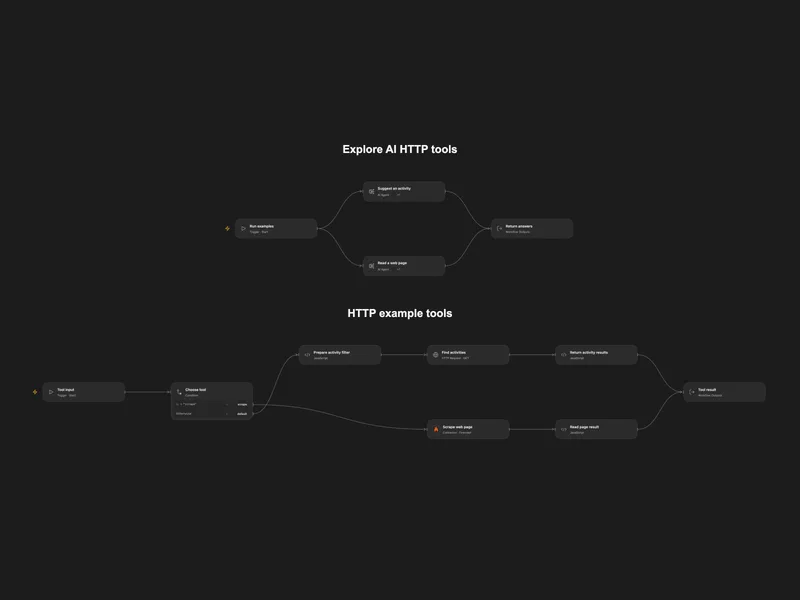
Explore AI HTTP Tools
Explore model-selected web scraping and activity search tools.
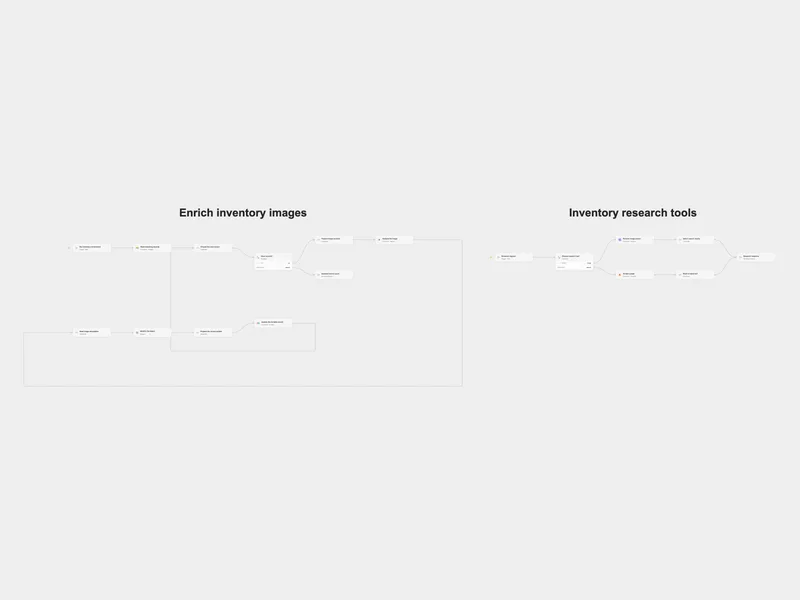
Enrich Airtable Inventory with Image Research
Research inventory images and update Airtable records with product attributes.
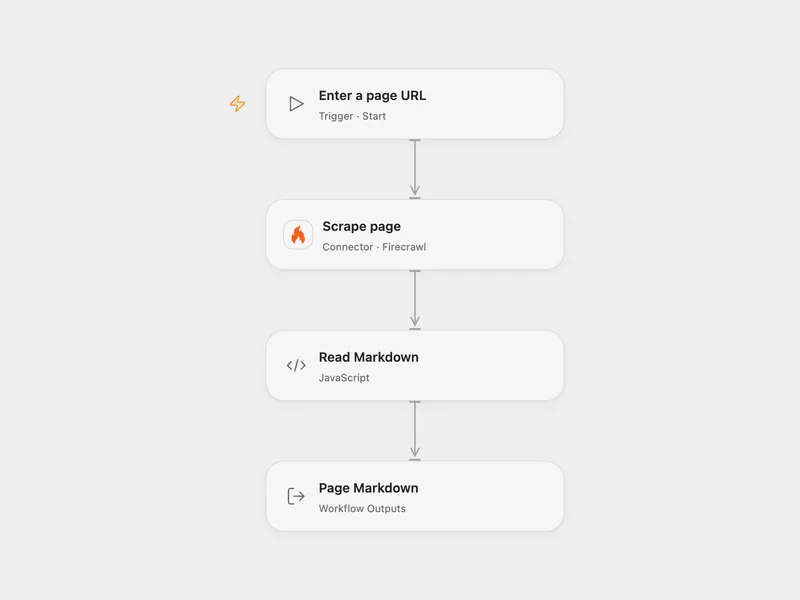
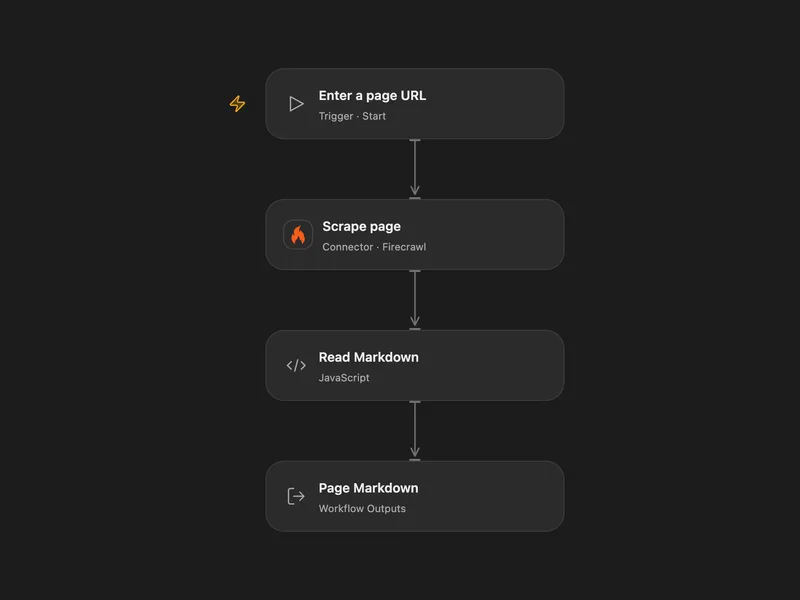
Scrape Page Markdown with Firecrawl
Call Firecrawl to scrape one page and return its Markdown.
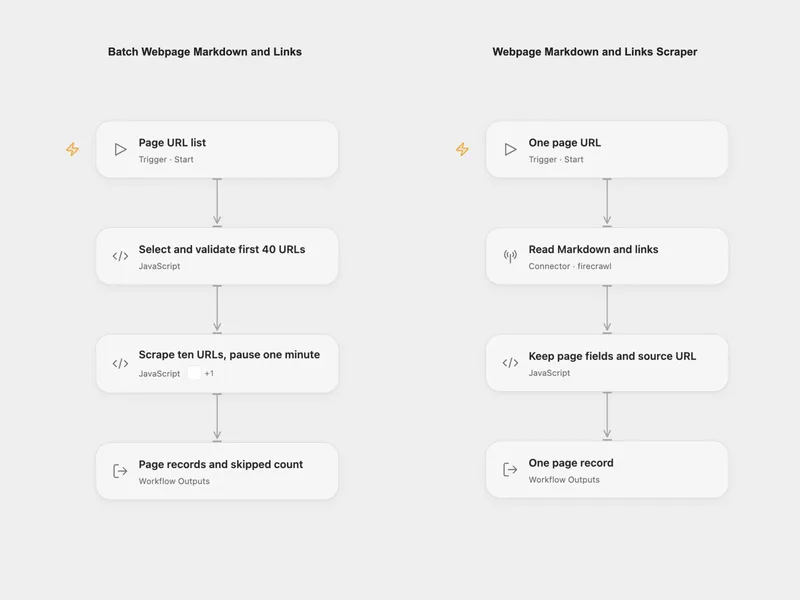
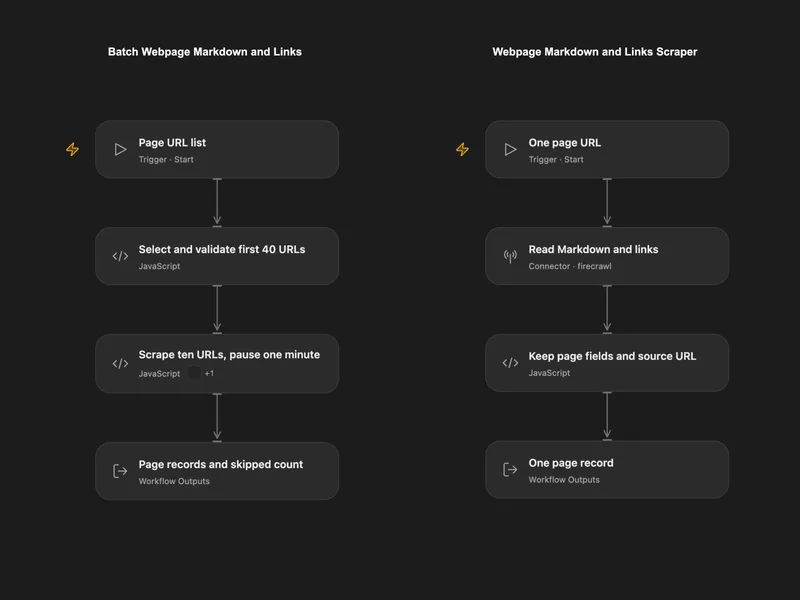
Batch Webpage Markdown and Links
Convert up to 40 page URLs into Markdown, metadata and link arrays, pausing one minute between groups of ten.
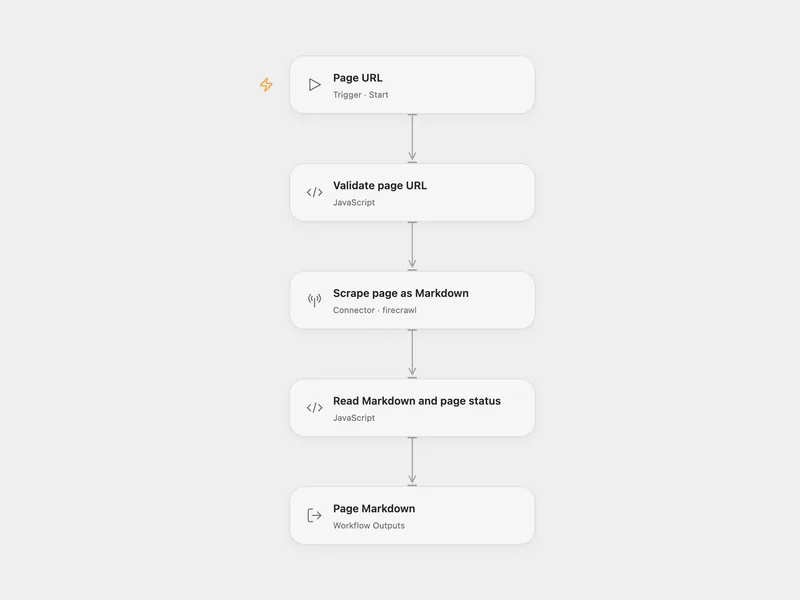
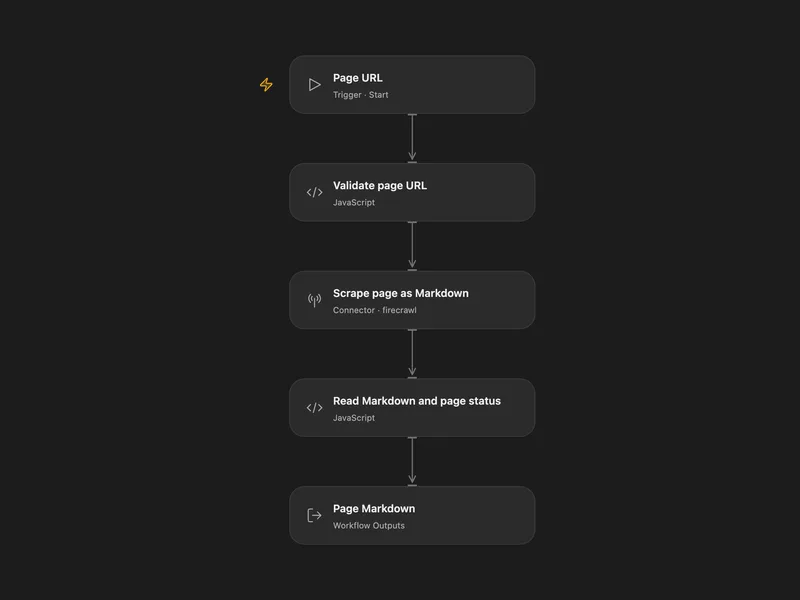
Webpage Markdown Extractor
Fetch one page through Firecrawl and return its Markdown content with the reported page status.
所有工具
Scrape
使用 Firecrawl 抓取 URL 或执行已启用的 Alexandria 提供方工具,并返回请求的输出格式。
firecrawl.scrapeBatch Scrape
为多个 URL 启动 Firecrawl 批量抓取作业,并返回异步作业 ID。
firecrawl.batch_scrapeBatch Scrape Get
按作业 ID 获取 Firecrawl 批量抓取作业的当前状态和分页结果。
firecrawl.batch_scrape_getBatch Scrape Get Errors
获取 Firecrawl 批量抓取作业中失败的 URL 和 robots.txt 阻止项。
firecrawl.batch_scrape_get_errorsBatch Scrape Cancel
按作业 ID 取消正在运行的 Firecrawl 批量抓取作业。
firecrawl.batch_scrape_cancelCrawl
启动 Firecrawl 爬取作业,接受来自旧版爬取输入的兼容字段。
firecrawl.crawlCrawl V2
使用官方 v2 抓取字段启动 Firecrawl 抓取作业,包括基于提示的选项生成。
firecrawl.crawl_v2Crawl Get
按作业 ID 获取 Firecrawl 抓取作业的当前状态和分页结果。
firecrawl.crawl_getGet The Status Of A Crawl Job
crawl_get 的兼容别名,用于 FIRECRAWL_GET_THE_STATUS_OF_A_CRAWL_JOB 操作名称。
firecrawl.get_the_status_of_a_crawl_jobCrawl Get Errors
获取 Firecrawl 抓取作业中失败的 URL 和 robots.txt 拦截记录。
firecrawl.crawl_get_errorsCrawl Cancel
按作业 ID 取消正在运行的 Firecrawl 抓取作业。
firecrawl.crawl_cancelCrawl Delete
crawl_cancel 的兼容别名,用于 FIRECRAWL_CRAWL_DELETE 操作名称。
firecrawl.crawl_deleteCrawl List Active
列出当前认证团队正在运行的 Firecrawl 抓取作业。
firecrawl.crawl_list_activeCrawl Params Preview
预览 Firecrawl 在开始抓取前从 URL 和提示中推断出的抓取参数。
firecrawl.crawl_params_previewExtract
启动 Firecrawl 提取作业,为一个或多个 URL 返回结构化数据。
firecrawl.extractExtract Get
按作业 ID 获取 Firecrawl 提取作业的当前状态和输出。
firecrawl.extract_getSearch
使用 Firecrawl 搜索网络,并可选择以请求的格式抓取顶部结果。
firecrawl.searchMap Multiple Urls Based On Options
使用旧操作名称通过 Firecrawl 的 map 端点发现网站 URL。
firecrawl.map_multiple_urls_based_on_optionsStart Agent
启动 Firecrawl 代理作业,进行多页面自主浏览和提取。
firecrawl.start_agentGet Agent Status
按作业 ID 获取 Firecrawl 代理作业的当前状态和输出。
firecrawl.get_agent_statusAgent Cancel
按作业 ID 取消正在运行的 Firecrawl 代理作业。
firecrawl.agent_cancelDeep Research
启动 Firecrawl 深度研究任务,由 agent 研究问题并返回 Markdown 报告和来源。
firecrawl.deep_researchGet Deep Research Status
按作业 ID 获取 Firecrawl 深度研究作业的当前状态和输出。
firecrawl.get_deep_research_statusLlms Txt Generate
启动网站 LLMs.txt 生成任务。Firecrawl 发现并批量抓取页面;将返回的 id、url 和 urls 一同传给 llms_txt_get。
firecrawl.llms_txt_generateLlms Txt Get
按作业 ID 获取 LLMs.txt 作业的当前状态和生成的内容。
firecrawl.llms_txt_getQueue Get
获取已认证 Firecrawl 团队的队列状态和并发信息。
firecrawl.queue_getCredit Usage Get
获取已认证 Firecrawl 团队当前的积分使用摘要。
firecrawl.credit_usage_getCredit Usage Get Historical
获取已认证 Firecrawl 团队的历史积分使用摘要。
firecrawl.credit_usage_get_historicalToken Usage Get
获取已认证 Firecrawl 团队当前的令牌使用摘要。
firecrawl.token_usage_getToken Usage Get Historical
获取已认证 Firecrawl 团队的历史令牌使用摘要。
firecrawl.token_usage_get_historical没有符合搜索条件的工具。
将 Firecrawl 接入 Open Flow
每月 20,000 次免费应用调用(付费服务另计)