条件
固定値や利用可能なデータを明示的に比較し、名前付きの実行分岐を選択します。
Condition は、状態、しきい値、空値、カテゴリの完全一致などの判定に使います。モデルは呼び出しません。
分岐を定義する
各分岐に名前と when 式を指定します。式は all や any で組み合わせられます。match が first なら最初の一致、all なら一致したすべての分岐を選びます。
{
  "op": "node.add", "as": "route", "type": "condition", "name": "Route a ticket",
  "config": {
    "match": "first",
    "branches": [{
      "name": "priority",
      "when": {
        "left": { "kind": "value", "value": "priority" },
        "operator": "==",
        "right": { "kind": "value", "value": "priority" }
      }
    }]
  }
}
オペランドには固定値のほか、対応する上流出力や変数を使えます。演算子とオペランド要件はスキーマで確認してください。
分岐経路を接続する
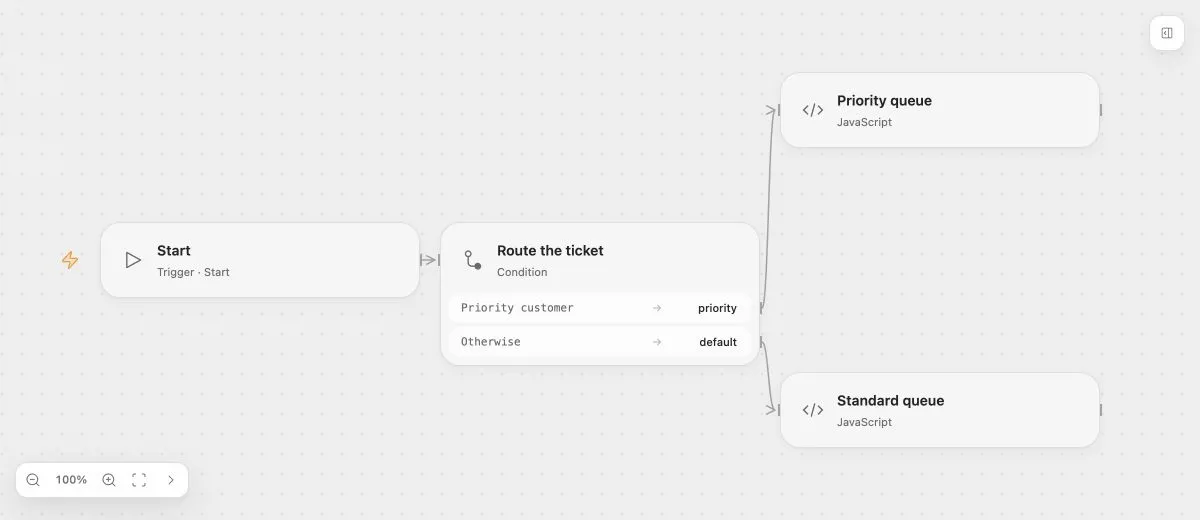
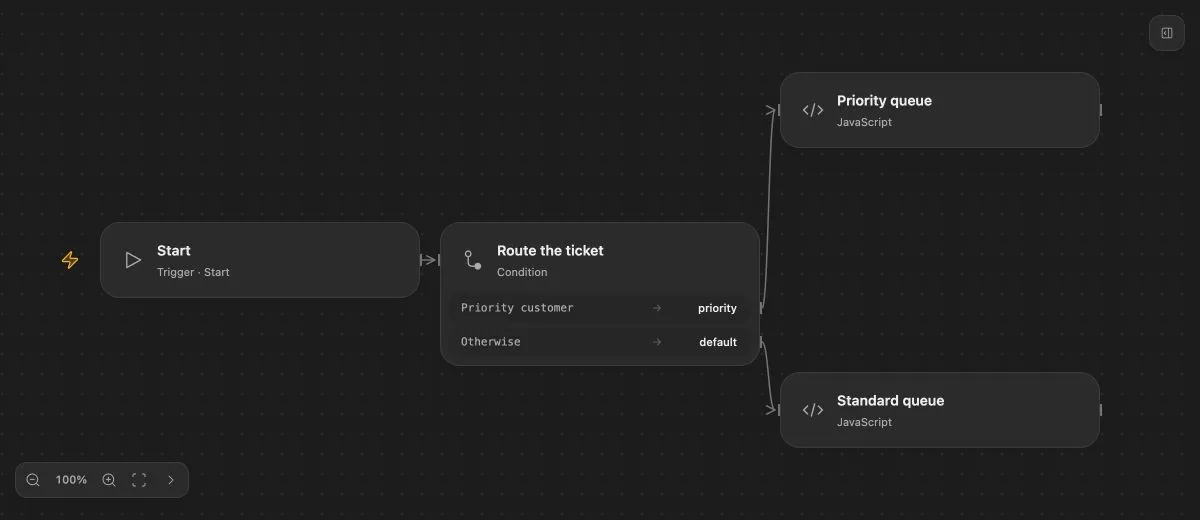
実行エッジの接続時に、分岐名を指定します。
{ "op": "edge.connect", "source": "$route", "branch": "priority", "target": "$escalate" }一致がなければ otherwise を選びます。match: "all" では複数分岐が続行できますが、下流の合流点では通常の前段待ちの規則が適用されます。
- 入力
- 比較する顧客ランクは "priority" です。
- 想定される結果
- Priority queue が選ばれます。ランクを他の値に変えると Standard queue が選ばれます。
- 実行前の準備
- インポートや実行には Open Flow サービスが必要です。プレビュー自体はオフラインで動作します。
データと制御
分岐名は実行の選択であり、データ出力ではありません。下流の業務データは実際の上流入力元からバインドします。処理済みタスクのシステムエラーも、エラーエッジを追加せずにここで比較できます。
モデルの評価には AI Decision を使い、構造化結果で分岐させます。Condition に通常の再試行やエラー処理の設定はありません。